
Principales puntos
- Predicciones sin entrenamiento tradicional: TabFM, un modelo de Google Research, analiza tablas con resultados conocidos y estima valores desconocidos sin exigir un nuevo ciclo de entrenamiento para cada conjunto de datos.
- Una IA que todavía no entiende el significado de los datos: entrenado exclusivamente con tablas sintéticas, el modelo identifica patrones numéricos, pero puede interpretar incorrectamente categorías, valores ausentes y convenciones específicas de cada negocio.
- La combinación con modelos de lenguaje: la arquitectura TabFusion Auto incorpora un LLM para interpretar nombres de columnas, preparar datos y orientar predicciones, aunque los riesgos de fuga de datos y las limitaciones de licencia siguen siendo relevantes.
La inteligencia artificial ya ha aprendido a escribir textos, generar imágenes, desarrollar software y responder preguntas complejas. Ahora, Google Research quiere avanzar en otro territorio: enseñar a los modelos de IA a realizar predicciones directamente a partir de tablas.
Aquí es donde entra TabFM, un modelo fundacional desarrollado específicamente para datos tabulares, organizados en filas y columnas que sustentan buena parte de las operaciones empresariales.
Pensemos en historiales de compras, registros de clientes, movimientos financieros, inventarios e indicadores de sensores. En lugar de desarrollar un modelo de machine learning desde cero para cada conjunto de datos, la propuesta consiste en proporcionar ejemplos conocidos y dejar que la IA estime los resultados que faltan.
La idea parece sencilla. Sin embargo, cambia una etapa importante del trabajo con inteligencia artificial.
📊 ¿Y si una tabla pudiera funcionar como un prompt?
Los modelos tradicionales de machine learning suelen exigir una secuencia de preparación, entrenamiento, evaluación y ajuste antes de empezar a producir predicciones fiables.
TabFM sigue otro camino.
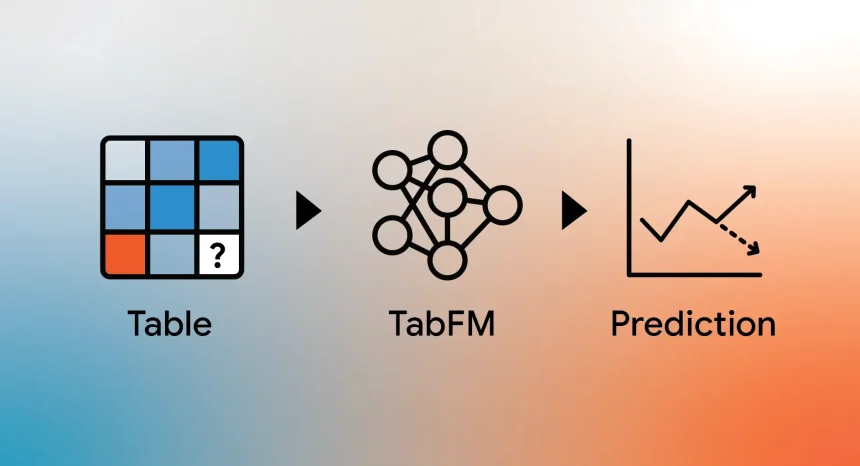
El modelo recibe una tabla que contiene dos grupos de registros: filas con resultados conocidos y filas cuyos resultados deben estimarse. A partir de las relaciones estadísticas presentes en los datos, intenta inferir los valores desconocidos en una sola pasada.
No es necesario actualizar los pesos del modelo ni crear un nuevo checkpoint para cada problema.
🔎 El detalle que marca la diferencia: la propia tabla funciona como una especie de prompt. Los ejemplos conocidos proporcionan el contexto necesario para que el modelo genere predicciones sobre los demás registros.
Este enfoque se conoce como in-context learning, o aprendizaje en contexto. El concepto se popularizó con los grandes modelos de lenguaje, que pueden ejecutar tareas a partir de ejemplos incluidos en la propia solicitud, sin necesidad de volver a entrenarse para cada situación.
En TabFM, la lógica se aplica a los datos tabulares.
| Enfoque | Cómo funciona |
|---|---|
| XGBoost y LightGBM | Requieren entrenamiento y ajustes para cada nuevo problema. |
| TabFM | Utiliza ejemplos etiquetados en el contexto para estimar resultados sin un entrenamiento específico para cada tabla. |
| TabFusion Auto | Combina TabFM con un modelo de lenguaje para interpretar los datos y orientar las predicciones. |
Esto no significa que TabFM elimine toda la preparación de datos ni que siempre supere a los modelos tradicionales. Su ventaja consiste en reducir la necesidad de un ciclo completo de entrenamiento para cada nueva tarea.
🧠 ¿Cómo enseñó Google a una IA a interpretar tablas?
Aquí aparece una de las características más interesantes de la investigación.
En lugar de entrenar TabFM exclusivamente con bases de datos reales, el equipo de Google Research utilizó tablas sintéticas generadas a partir de grafos causales aleatorios.
Un grafo causal representa las relaciones entre variables. Por ejemplo, en un escenario hipotético, los ingresos, los gastos y el endeudamiento podrían estar conectados mediante diferentes relaciones estadísticas.
El proceso de entrenamiento crea estructuras aleatorias de este tipo, genera registros compatibles con ellas y oculta determinados valores. El modelo debe aprender a estimar la información que falta utilizando el resto de la tabla.
Al repetir este proceso con muchas estructuras diferentes, el objetivo es enseñar una estrategia general de predicción, en lugar de hacer que el sistema memorice una base de datos específica.
💡 La apuesta de Google: en vez de aprender los detalles de cada conjunto de datos, el modelo aprende patrones sobre cómo pueden relacionarse las distintas informaciones tabulares.
Es una diferencia importante. El objetivo no es crear una IA especializada en predecir cancelaciones de suscripciones o detectar fraudes, sino desarrollar una base capaz de abordar diferentes tareas tabulares utilizando el contexto disponible.
⚠️ El problema: los números no cuentan toda la historia
Si TabFM puede identificar relaciones estadísticas sin un entrenamiento específico, ¿por qué no sustituir de una vez a los modelos tradicionales?
Porque existe una diferencia entre reconocer patrones numéricos y comprender el significado de los datos.
El modelo se entrenó con tablas sintéticas que no contienen nombres semánticos de columnas como «facturación mensual», «edad del cliente» o «tickets de soporte». Por eso, no conoce automáticamente el significado de cada variable.
Consideremos una columna con los valores 1, 2 y 3.
Estos números pueden representar niveles de satisfacción, categorías de productos o tipos de incidencia. Dependiendo del contexto, tratarlos como números convencionales puede distorsionar las relaciones identificadas por el modelo.
Lo mismo ocurre con los valores ausentes.
En una base de datos empresarial, el número cero puede significar ausencia de actividad, un valor medido real o incluso un código utilizado para indicar información no disponible. Sin conocer esta convención, la IA corre el riesgo de llegar a conclusiones equivocadas.
📉 El efecto práctico: según el artículo de referencia, en una prueba de predicción de cancelaciones de clientes, la salida directa de TabFM quedó por debajo de un modelo de árboles de decisión con gradient boosting debidamente ajustado.
Esto demuestra que prescindir del entrenamiento específico no garantiza una mayor precisión. En determinadas tareas, el conocimiento del dominio, la preparación de los datos y los ajustes del modelo tradicional siguen marcando la diferencia.
🤝 TabFusion Auto: cuando un LLM entra para interpretar los datos
La propuesta descrita por los investigadores de Google para superar esta limitación es TabFusion Auto.
La arquitectura combina TabFM, cuyos pesos permanecen congelados durante la inferencia, con un gran modelo de lenguaje, o LLM, que funciona como agente de orquestación.
En la práctica, cada componente asume una responsabilidad diferente.
LLM: interpretación y planificación
Analiza los nombres de las columnas y la documentación, identifica el contexto del problema, prepara transformaciones en los datos y selecciona ejemplos relevantes.
TabFM: predicción estadística
Utiliza las relaciones presentes en las tablas para estimar los resultados desconocidos, sin ajustar sus propios pesos para cada tarea.
Capa de evaluación
Evalúa los resultados y puede orientar ajustes en la preparación de los datos y en la selección de variables.
La división de responsabilidades es el punto central de la propuesta. El modelo de lenguaje ayuda a comprender qué representan los datos, mientras que TabFM se encarga del mecanismo de predicción.
Según el material de referencia, la configuración combinada obtuvo resultados competitivos en TabArena, un benchmark público de métodos de predicción tabular.
Sin embargo, hay una salvedad: el código original de TabFusion Auto no se ha publicado, según el artículo. Por tanto, reproducir la arquitectura requiere una implementación propia.
🏢 ¿Dónde puede resultar útil en las empresas?
La combinación resulta especialmente interesante para organizaciones que trabajan con múltiples bases de datos y necesitan crear predicciones para diferentes problemas.
Entre las aplicaciones potenciales se encuentran:
- Comercio minorista: estimar la demanda, identificar patrones de compra y apoyar la planificación de inventarios.
- Marketing y CRM: predecir la propensión de compra, segmentar clientes y estimar el riesgo de cancelación.
- Finanzas: identificar patrones asociados al impago e investigar señales de fraude.
- Operaciones industriales: analizar registros de sensores y estimar posibles fallos o cambios en el rendimiento.
Estos son ejemplos de aplicaciones de este enfoque, no una garantía de que TabFM ofrezca un rendimiento superior en estas tareas.
El beneficio potencial consiste en experimentar con nuevas predicciones reduciendo el trabajo de entrenamiento específico. A cambio, los resultados deben compararse con modelos tradicionales y evaluarse en condiciones que representen el uso real.
🚨 El riesgo que puede arruinar una predicción aparentemente perfecta
La automatización introduce otro desafío: permitir que un agente de IA explore datos, seleccione variables y escriba código sin una supervisión adecuada.
El principal peligro es el data leakage, o fuga de datos.
Esto ocurre cuando el modelo recibe información que no estaría disponible en el momento en que debería realizarse la predicción. El resultado puede parecer excelente durante las pruebas, pero fallar cuando se utiliza para anticipar acontecimientos futuros.
Imaginemos una empresa que quiere predecir qué clientes cancelarán sus suscripciones.
Una columna denominada «oferta de retención enviada» puede presentar una fuerte correlación con la cancelación. Sin embargo, si esa información solo se completa después de que el cliente inicia el proceso de baja, no ayuda a predecir la cancelación por adelantado. Simplemente revela que el proceso ya ha comenzado.
💡 Una predicción precisa sobre el pasado no es necesariamente una predicción útil sobre el futuro.
Si el agente selecciona automáticamente esa columna, puede construir un modelo aparentemente excelente durante la evaluación y poco fiable en una operación real.
El problema no es exclusivo de TabFM. Afecta a los sistemas de machine learning en general, pero adquiere mayor importancia cuando los agentes automatizan la selección de variables y la experimentación.
Tres precauciones para evitar resultados engañosos
1️⃣ Aislar los experimentos: cada prueba debe trabajar en una copia o un entorno separado, sin modificar directamente las tablas de producción.
2️⃣ Preservar el historial temporal: las pruebas deben considerar los datos exactamente tal como estaban disponibles en la fecha en que se habría realizado la predicción.
3️⃣ Documentar las variables: los nombres, significados, reglas de cumplimentación y fechas de disponibilidad deben estar claros tanto para el agente como para quienes evalúan los resultados.
Sin estas medidas, automatizar el desarrollo de modelos puede acelerar la producción de errores con la misma eficacia con la que acelera el análisis de datos.
🔒 ¿Se puede utilizar TabFM en productos comerciales?
Todavía existe una barrera importante.
Según el material de referencia, los pesos publicados de TabFM están disponibles bajo una licencia destinada a usos no comerciales y de investigación. Esto limita su utilización directa en productos comerciales, de acuerdo con los términos de dicha licencia.
Es necesario distinguir dos cosas: estudiar la arquitectura e incorporarla a un sistema que genera ingresos. La segunda posibilidad exige verificar las condiciones de la licencia y no debe darse por permitida.
El artículo también señala que la arquitectura original de TabFusion Auto no tiene su código disponible públicamente. Esto dificulta reproducir exactamente los resultados descritos por los investigadores.
Para los equipos tecnológicos, por tanto, el interés inmediato puede estar menos en implementar el modelo específico y más en estudiar la arquitectura: predicción tabular en contexto, interpretación semántica mediante LLM y experimentación controlada con bases de datos.
🔮 La próxima etapa de la IA podría estar en las hojas de cálculo
TabFM representa un intento de trasladar a los datos estructurados una de las características más importantes de los modelos de lenguaje: la capacidad de ejecutar diferentes tareas sin necesitar un entrenamiento específico para cada una.
La combinación con un LLM hace que la propuesta resulte más interesante, porque acerca el razonamiento estadístico al contexto empresarial. Sin embargo, no elimina los problemas de calidad de los datos, interpretación de las variables, validación de resultados y licencias.
La cuestión ahora es descubrir hasta dónde puede avanzar este enfoque frente a modelos tradicionales bien ajustados y bases de datos reales, con todas las inconsistencias que estas contienen.
Si la combinación evoluciona, parte del trabajo que hoy exige especialistas para preparar, entrenar y ajustar modelos podría automatizarse. El desafío será garantizar que la IA no solo encuentre patrones en las tablas, sino que también sepa distinguir una predicción legítima de una coincidencia producida por los propios datos.